

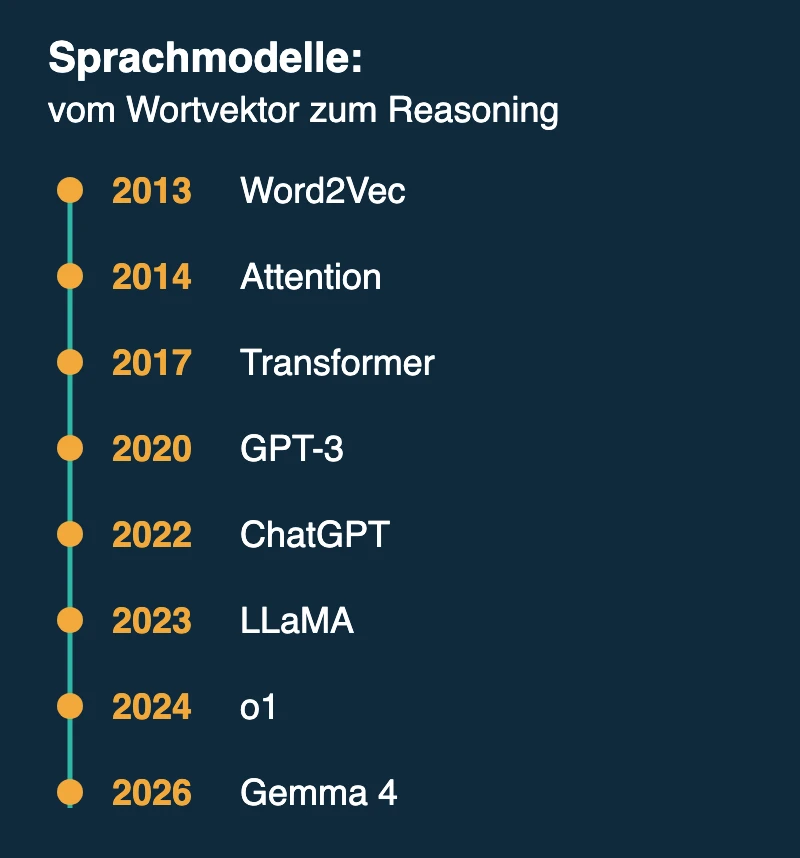
ChatGPT wirkte Ende 2022 wie aus dem Nichts. War es aber nicht. Dahinter lagen fast zehn Jahre Forschung, und fast jeder Schritt löste genau ein Problem des vorherigen.
Erst Wörter als Zahlen, dann ganze Sätze
Word2Vec zeigte 2013, wie man Wörter billig als Zahlenreihen lernt 1. 2014 kam der nächste Schritt: Attention erlaubte dem Modell, beim Übersetzen im Quellsatz nachzuschlagen, statt alles in einem einzigen Vektor zu merken 2.
Der Transformer machte alles parallel
2017 strich der Transformer die alte Rechenschleife und setzte nur noch auf Attention 3. Das Training ließ sich dadurch viel besser parallelisieren.
GPT-3 und ChatGPT: vom Paper zum Alltag
GPT-3 brachte 2020 einen Wechsel: Aufgaben ließen sich mit ein paar Beispielen im Prompt lösen, ohne neues Training 4. Ende 2022 machte ChatGPT daraus eine Weboberfläche für alle.
Danach wurde es offener, kleiner und nachdenklicher
LLaMA zeigte 2023, dass kleinere Modelle mit guten Daten weit kommen 5. Phi-1 trieb das noch weiter 6. Und Reasoning-Modelle wie o1 und DeepSeek-R1 machten aus mehr Rechenzeit beim Antworten bessere Ergebnisse, R1 sogar offen 7.
Mein Eindruck: Die großen Sprünge kamen selten durch mehr Größe allein. Oft kam eine bessere Idee zuerst. Heute läuft gerade die nächste Runde, mit Diffusion für Text und NCM.
Stand: 01.11.2026. Herstellerzahlen sind nicht unabhängig geprüft. Titelbild: KI-generiert (MiniMax image-01).
Quellen
- Mikolov et al.: Word2Vec, 2013, arXiv:1301.3781.
- Bahdanau et al.: Attention, 2014, arXiv:1409.0473.
- Vaswani et al.: Attention Is All You Need, 2017, arXiv:1706.03762.
- Brown et al.: GPT-3, 2020, arXiv:2005.14165.
- Touvron et al.: LLaMA, 2023, arXiv:2302.13971.
- Gunasekar et al.: Phi-1, 2023, arXiv:2306.11644.
- DeepSeek: R1, 2025, arXiv:2501.12948.