

Die Idee hinter den Bildgeneratoren stammt aus der Thermodynamik. Tinte verteilt sich im Wasser. Was, wenn ein Modell lernt, diesen Vorgang rückwärts laufen zu lassen?
2015: eine schöne Idee, die fünf Jahre schlief
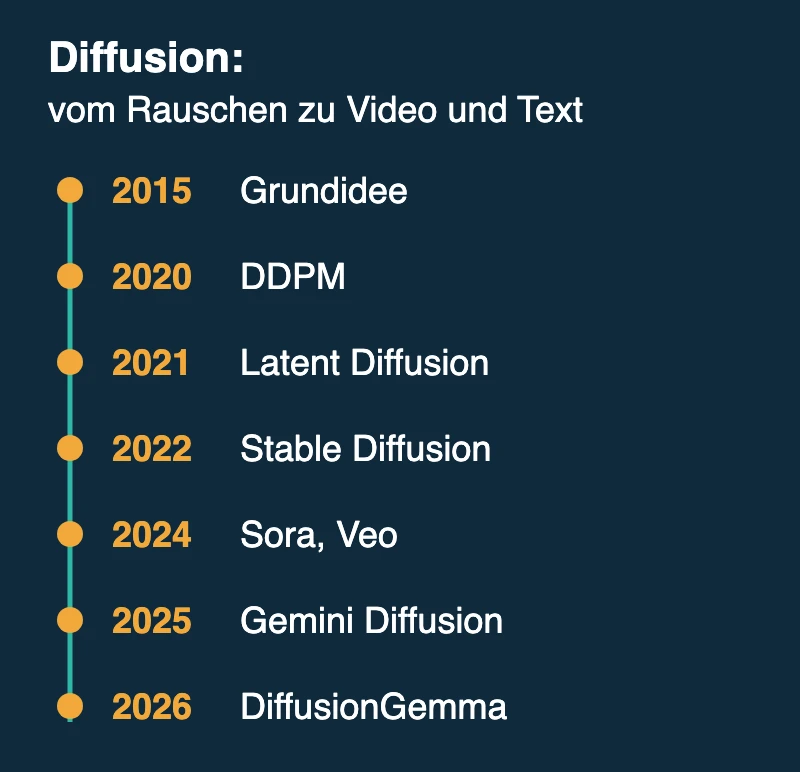
Sohl-Dickstein und Kollegen beschrieben 2015, wie man Daten verrauscht und die Umkehrung lernt 1. Der Durchbruch kam erst 2020: DDPM lieferte Bilder in hoher Qualität 2.
Der Trick, der es billig machte
Latent Diffusion rechnet nicht mehr auf Pixeln, sondern in einem kleineren Zahlenraum 3. Das spart viel Rechenzeit. Darauf baut Stable Diffusion auf, das 2022 offen erschien. Im selben Jahr zeigte DALL-E 2, wie gut Text-zu-Bild werden kann 4.
Von Bild zu Video
Flow Matching brachte 2022 eine neue Trainingsart 5. 2024 folgte Video: Sora und Veo erzeugten aus Text ganze Clips.
Jetzt ist Text dran
Gemini Diffusion zeigte im Mai 2025, dass Text aus Rauschen entstehen kann. Mercury lieferte kurz darauf ein Paper dazu 6. Im Juni 2026 machte Google mit DiffusionGemma ein offenes Modell daraus. Google sagt selbst, dass die Qualität unter Gemma 4 liegt 7.
Die Geschichte zeigt: Diffusion brauchte Jahre, bis sie bei Bildern gut war. Bei Text steht sie am Anfang. Was das heute kann, steht unter Diffusionsmodelle einfach erklärt.
Stand: 01.11.2026. Herstellerzahlen sind nicht unabhängig geprüft. Titelbild: KI-generiert (MiniMax image-01).
Quellen
- Sohl-Dickstein et al., 2015, arXiv:1503.03585.
- Ho, Jain, Abbeel: DDPM, 2020, arXiv:2006.11239.
- Rombach et al.: Latent Diffusion, 2021, arXiv:2112.10752.
- Ramesh et al.: unCLIP, 2022, arXiv:2204.06125.
- Lipman et al.: Flow Matching, 2022, arXiv:2210.02747.
- Inception Labs: Mercury, 2025, arXiv:2506.17298.
- Google: DiffusionGemma, 10.06.2026. https://blog.google/innovation-and-ai/technology/developers-tools/diffusion-gemma-faster-text-generation/