

Anfang 2022 fanden Forscher einen simplen Trick: Wenn man dem Modell Zwischenschritte zeigt, rechnet es besser. Vier Jahre später fragen andere Forscher, ob diese Schritte überhaupt Text sein müssen.
Erst denken lernen
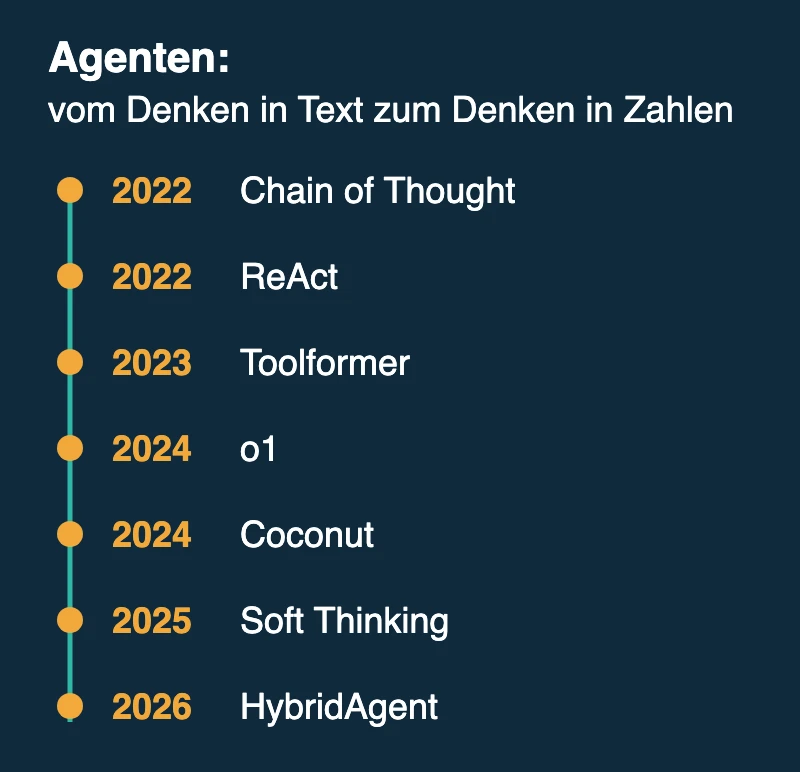
Chain of Thought zeigte Anfang 2022: Beispiele mit Zwischenschritten verbessern das Rechnen 1. ReAct wechselte im selben Jahr zwischen Denken und Handeln, etwa einer Abfrage bei Wikipedia 2. Toolformer lernte selbst, wann es ein Werkzeug braucht 3.
Denken wird teuer
Reasoning-Modelle wie o1 und DeepSeek-R1 machten daraus ein Prinzip: mehr Denkzeit, bessere Antwort. R1 zeigte das offen 4. Der Preis sind viele Tokens, die niemand liest.
Denken ohne Worte
Coconut ließ das Modell Ende 2024 im Zahlenraum denken 5. Soft Thinking sparte 2025 Tokens ohne neues Training 6. Beiden fehlte aber das Handeln mit Werkzeugen.
Der Wechsel zwischen beiden Welten
HybridAgent verbindet im Oktober 2026 beide Wege in einem Lauf 7. Die gemeldeten Einsparungen sind groß, aber nicht unabhängig bestätigt. Wie es funktioniert, steht unter Hybrid Reasoning Agents einfach erklärt.
Stand: 01.11.2026. Herstellerzahlen sind nicht unabhängig geprüft. Titelbild: KI-generiert (MiniMax image-01).
Quellen
- Wei et al.: Chain of Thought, 2022, arXiv:2201.11903.
- Yao et al.: ReAct, 2022, arXiv:2210.03629.
- Schick et al.: Toolformer, 2023, arXiv:2302.04761.
- DeepSeek: R1, 2025, arXiv:2501.12948.
- Coconut, 2024, arXiv:2412.06769.
- Soft Thinking, 2025, arXiv:2505.15778.
- Zou et al.: Hybrid Reasoning Agents, 2026, arXiv:2610.18861.