

2020 war Diffusion für Bilder noch ein frisches Forschungsthema. Zwei Jahre später lief Text-zu-Bild auf normalen Rechnern, weitere zwei Jahre später kam Video. Das ging schneller als bei Text.
Der Weg zum Bild
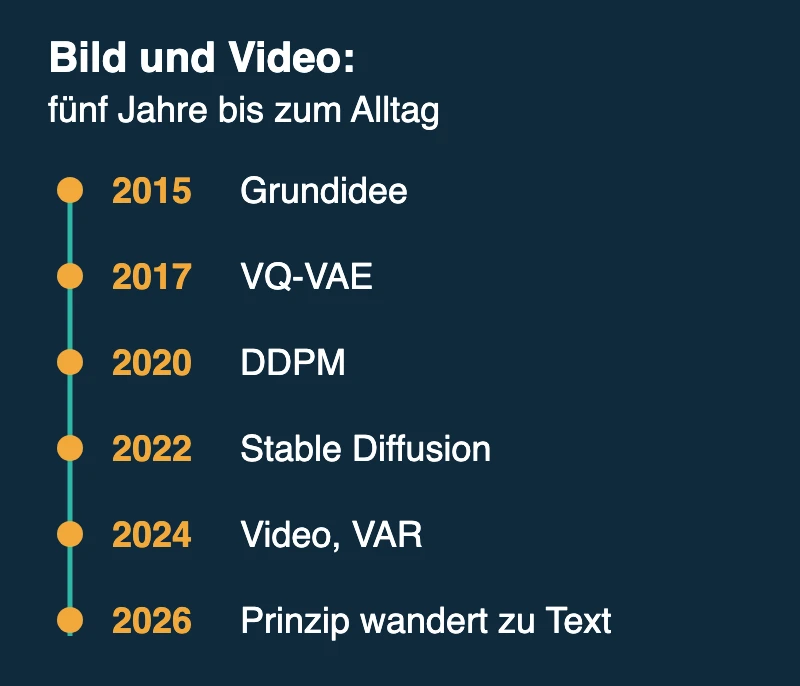
Von der Idee 2015 bis zu DDPM 2020 vergingen fünf Jahre. Dann ging es schnell: Latent Diffusion senkte den Rechenaufwand 1, Stable Diffusion erschien 2022 offen. Details: So entstand Diffusion.
Video ist Bild mit Zeit
Sora arbeitete 2024 mit Diffusion auf kleinen Raum-Zeit-Stücken und erzeugte bis zu etwa einer Minute Video 2. Google zog mit Veo nach 3. Der Sprung gelang, weil die Grundtechnik schon stand.
Der zweite Weg lief mit
Parallel entstand die Linie mit festen Bausteinen, von VQ-VAE bis VAR. Sie zeigte: Von grob nach fein geht es schnell. Genau dieses Prinzip kam 2026 mit NCM zum Text.
Das finde ich das Interessanteste an diesem Bereich: Bild und Video sind seit Jahren das Testfeld für Ideen, die später bei Text landen.
Stand: 01.11.2026. Herstellerzahlen sind nicht unabhängig geprüft. Titelbild: KI-generiert (MiniMax image-01).
Quellen
- Rombach et al.: Latent Diffusion, 2021, arXiv:2112.10752.
- OpenAI: Video generation models as world simulators, Februar 2024. https://openai.com/index/video-generation-models-as-world-simulators/
- TechCrunch: Google Veo, 14.05.2024. https://techcrunch.com/2024/05/14/google-veo-a-serious-swing-at-ai-generated-video-debuts-at-google-io-2024