

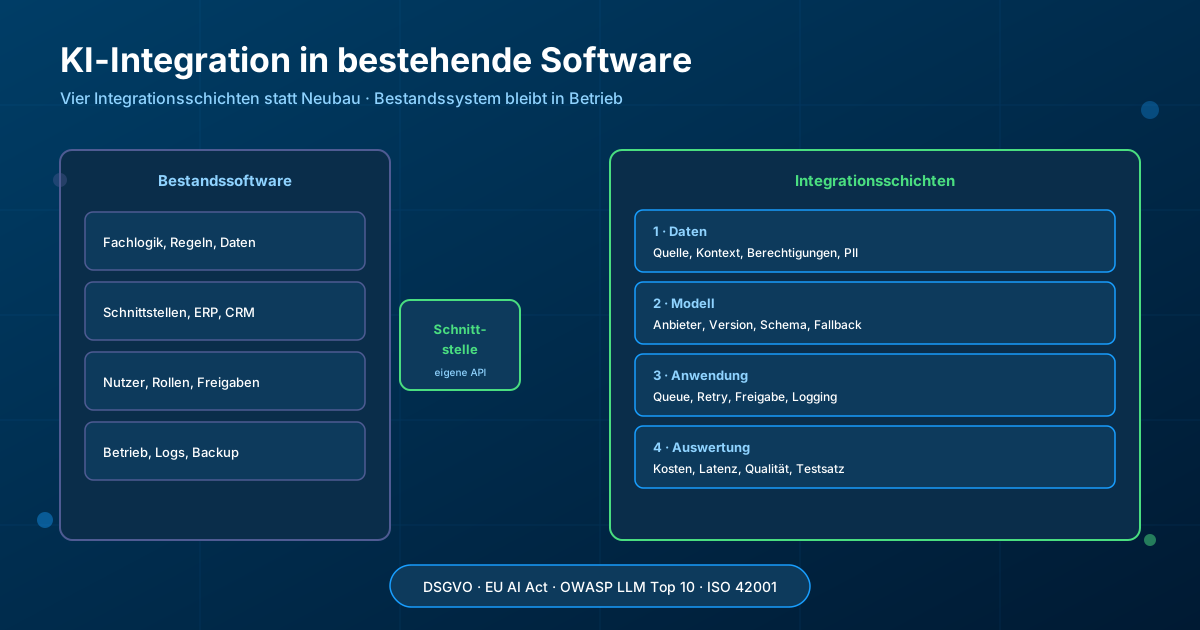
KI-Integration in bestehende Software heißt: ein Sprachmodell als zusätzliche Komponente in eine Anwendung einbauen, die bereits läuft. Fachlogik, Datenbestand, Schnittstellen und Nutzerrechte bleiben, wo sie sind. Neu ist nur die Fähigkeit, unstrukturierte Eingaben zu verstehen, Vorschläge zu erzeugen oder Texte zu erzeugen. Der Aufwand liegt nicht im API-Aufruf, sondern in den Fragen dahinter: Welcher Anwendungsfall trägt, wo endet die Autonomie des Modells, wie bleibt die Anwendung betreibbar, wenn der Anbieter ausfällt, und was muss nachgewiesen werden, damit die Integration im Betrieb erlaubt ist.
Warum Bestandssoftware und KI-Schnittstelle die Regel sind
Der Reflex in vielen Projekten lautet: „Wir bauen neu." Das ist selten die richtige Antwort. Eine Anwendung, die heute Rechnungen schreibt, Bestände pflegt und mit dem Buchhaltungssystem spricht, hat etwas, das ein Sprachmodell nicht liefert: ein geprüftes Verhalten, das über Jahre gewachsen ist. Diese Fachlogik zu ersetzen, weil eine KI-Funktion moderner klingt, ist der teuerste Weg zum Ziel – und der langsamste.
Die zweite Fehlannahme: KI wird „eingebaut", als wäre sie eine weitere Bibliothek. Ein Sprachmodell unterscheidet sich von einer Bibliothek in einem entscheidenden Punkt. Eine Bibliothek liefert bei gleicher Eingabe dieselbe Ausgabe. Ein Modell nicht. Das bedeutet, dass der Aufbau einer KI-Schnittstelle nicht mit dem Einbinden endet, sondern mit den Fragen beginnt, die eine klassische Komponente nicht stellt: Was passiert bei einer Ausgabe, die nicht dem erwarteten Format entspricht? Was passiert, wenn der Anbieter nicht erreichbar ist? Wer entscheidet, ob eine Antwort verwendet wird?
Der Unterschied in einem Satz
- Regelbasiert: Gleiche Eingabe, gleiche Ausgabe. Fehler sind vorhersagbar und testbar.
- Modellbasiert: Gleiche Eingabe, möglicherweise andere Ausgabe. Deshalb braucht jede Integration einen Prüfpunkt, an dem eine deterministische Regel oder ein Mensch entscheidet.
Die vier Integrationsschichten
Eine KI-Integration in Bestandssoftware ist keine, sondern vier Aufgaben. Wer nur die erste umsetzt, hat ein Demo gebaut. Wer alle vier umsetzt, hat eine Funktion, die im Betrieb nichts kaputt macht.
1. Daten: Woher die Information kommt
Die Datenebene entscheidet über die Qualität der Antwort und über die rechtliche Bewertung. Zwei Fragen müssen vor der Implementierung beantwortet werden: Aus welchen Quellen stammt der Kontext, und welche personenbezogenen Daten verlassen dabei das eigene System?
Der Standardfall ist eine Verknüpfung mit dem Datenbestand, den die Anwendung ohnehin schon führt – Bestellpositionen, Verträge, Ticketverlauf. Dafür braucht es meist keine neue Anbindung, sondern einen Lesezugriff auf die vorhandene Schnittstelle. Anders liegt es bei unstructured Quellen: eingescannte Belege, E-Mails, Chatverläufe. Hier ist die Frage zu stellen, ob die Daten überhaupt das eigene System verlassen dürfen.
Für die Auswahl der Daten gilt die Datenschutz-Grundverordnung (Verordnung (EU) 2016/679, Art. 5 und 6): Datenminimierung und Zweckbindung gelten auch für den Kontext, den Sie einem Modell schicken. Über die konkrete Umsetzung – Auftragsverarbeitung, Betrieb in der EU, kein Training auf Ihre Daten – sollten Sie mit Ihrem Datenschutzbeauftragten sprechen, bevor der erste Prompt läuft. Die Übersicht der EU-AI-Verordnung ordnet ein, welche Pflichten für welches System gelten.
2. Modell: Anbieter, Version, Rückfall
Auf der Modellebene wird entschieden, wer die Antwort erzeugt und was passiert, wenn das nicht klappt. Drei Festlegungen gehören zusammen und werden gemeinsam getroffen: welcher Anbieter, welche Version und welches Antwortformat.
Das Antwortformat ist der wichtigste Hebel. Wenn das Modell verpflichtend strukturiert antwortet – etwa als JSON-Schema –, kann die Anwendung die Ausgabe technisch prüfen, statt sie zu interpretieren. Was nicht dem Schema entspricht, wird verworfen oder geht zur manuellen Prüfung. Das ist der Unterschied zwischen „das Modell hat sich geirrt" und „die Integration hat funktioniert".
Der teure Fehler: nur einen Anbieter einkaufen
Modelle, Preise und Verfügbarkeit ändern sich laufend. Wird der Modellanbieter direkt im Anwendungscode aufgerufen, wird jeder Wechsel zu einem Projekt. Liegt der Aufruf hinter einer eigenen Schnittstelle – ein schmales Interface, das ich austauschen kann, ohne die Fachlogik anzufassen –, ist ein Wechsel eine Konfigurationsänderung. Das ist kein Over-Engineering, das ist die Voraussetzung dafür, dass die Integration in zwei Jahren noch läuft.
3. Anwendung: Warteschlange, Wiederholung, Freigabe
Hier entscheidet sich, ob die Integration in den Betrieb passt. Ein Modellaufruf dauert Sekunden, nicht Millisekunden. Ein Request-Thread, der so lange wartet, ist im Produktivbetrieb eine Ausfallquelle. Längere Modellaufrufe gehören deshalb in eine Warteschlange, nicht in den Web-Request.
Für die Anwendungsebene gelten vier Regeln:
- Fehlerwege sind definiert. Timeout, Rate-Limit und Abbruch führen zu einem bekannten Verhalten, nicht zu einer stillen Leere.
- Wiederholung ist begrenzt. Wiederholungen sind bei Modellen teuer. Eine Wiederholungsschleife ohne Limit ist ein Kostenrisiko und ein Ausfallrisiko zugleich.
- Freigabeobereiche sind benannt. Ein Modell darf vorbereiten. Ob eine Antwort ohne Menschen zur Ausführung kommt, wird pro Anwendungsfall entschieden – und nicht global.
- Der Betriebszustand ist einsehbar. Latenz, Kosten und Fehlerquoten liegen im Monitoring, nicht in einer Excel-Tabelle.
Der Betriebszustand ist auch das, was die Qualitätsaussage trägt: Ohne Messung ist jede Änderung an einem Prompt geraten. Ein Testsatz aus echten Fällen – Eingabe, erwartetes Ergebnis, Toleranz – macht jede Änderung prüfbar.
4. Auswertung: Kosten, Latenz, Qualität
Auf der Auswertungsebene stehen die drei Zahlen, die am Ende über Erfolg oder Misserfolg entscheiden: Kosten je Vorgang, Latenz im producing Betrieb und Qualität im Vergleich zur bisherigen Lösung.
Kosten entstehen pro Token, pro Anfrage und pro Retry. Für die Kalkulation hilft eine einfache Frage: Wie viele Aufrufe entstehen je Nutzeraktion, und wie viele davon sind Retries? Ein Cache für wiederholte Anfragen, ein kleineres Modell für einfache Klassifikationen und ein Batch statt eines Einzelaufrufs senken die Rechnung oft stärker als jede Prompt-Optimierung.
Der Qualitätsvergleich braucht eine ehrliche Referenz. Was macht die bisherige Lösung heute – ein Suchfeld, eine Regex, ein manueller Vorgang? Wenn die KI-Ausgabe schlechter ist als der Status quo, ist sie keine Verbesserung, auch wenn sie moderner klingt.
| Kriterium | KI sinnvoll, wenn … | Regelwerk bleibt, wenn … |
|---|---|---|
| Art der Eingabe | unstrukturierter Text, Sprache, Semantik | strukturierte Werte, feste Felder, Zahlen |
| Fehlerfolge | ein Fehler ist reversibel und wird erkannt | ein Fehler ist teuer oder irreversibel |
| Regelwerk | die Regel lässt sich nicht vollständig formalisieren | die Regel vollständig formalisierbar ist |
| Verfügbarkeit | ein regelbasierter Rückfall existiert | die Funktion ohne Modell nicht existieren kann |
| Datenschutz | zulässige Datenbasis ist geklärt | Datenbasis oder Zweck nicht geklärt ist |
| Messbarkeit | ein Testsatz aus echten Fällen existiert | keine Referenzmessung möglich ist |
Der Betrieb: fünf Punkte, die in der Praxis entscheiden
Der Unterschied zwischen einer Demo und einer produktiven Funktion entsteht im Betrieb. Diese fünf Punkte sind es, die dort zählen.
Fallback: die Anwendung darf stehenbleiben
Wenn der Anbieter nicht erreichbar ist, muss die Anwendung weiterlaufen. Für jede KI-Funktion wird deshalb eine regelbasierte Rückfallebene definiert: der alte Suchpfad, die manuelle Prüfung oder eine verkleinerte Teilfunktion. Diese Rückfallebene ist ein Feature, kein Notnagel – sie wird getestet, und zwar im Normalbetrieb, nicht nur im Fehlerfall.
Kosten: ein Budget, das greift
Ohne Budget sind Modellkosten eine Überraschung in der nächsten Rechnung. Ein tägliches oder monatliches Limit mit automatischer Sperre, kombiniert mit einem Abbruch pro Nutzeraktion, verhindert den Ausreißer. Modelle arbeiten inzwischen auch mit reduzierter Genauigkeit für einfache Aufgaben – das senkt Kosten und Latenz gleichzeitig.
Latenz: die Antwortzeit, die der Nutzer spürt
Was der Nutzer spürt, ist nicht die Modellzeit, sondern die Gesamtzeit bis zur fertigen Antwort im Bildschirm. Streaming, ein sinnvoller Zwischenzustand und ein Abbruch, wenn der Nutzer abbrechen will, sind hier wirksamer als jede Optimierung am Prompt.
Protokollierung: nachweisen, nicht nur vermuten
Für den Betrieb brauchen Sie eine Auskunft, die auch Monate später trägt: Was wurde wann welchem Modell übergeben, mit welcher Antwort, und was ist mit der Antwort geschehen? Solche Protokolle enthalten allerdings Inhalte. Sie gehören geschützt und gekürzt in die Anwendung und dürfen nicht ungeprüft an den Modellanbieter gehen.
Qualität: ein Testsatz statt Bauchgefühl
Der Testsatz aus echten Fällen ist das Werkzeug, das die subjektive Debatte über „ist die Antwort gut" in eine Prüfung verwandelt. Er wird vor jeder Änderung an Modell, Prompt oder Version ausgeführt und mit dem aktuellen Stand verglichen.
Sicherheit: das Modell ist ein neuer Angriffsvektor
Eine KI-Schnittstelle verändert die Angriffsfläche einer Anwendung. Der wichtigste neue Angriffsweg ist die Prompt Injection: Text, der nicht als Daten, sondern als Anweisung gelesen wird. Sie kann direkt aus der Nutzereingabe kommen oder indirekt aus externen Inhalten, die die Anwendung verarbeitet – eine E-Mail, ein Dokument, eine Webseite. Das OWASP-Projekt führt diese Klasse als LLM01 Prompt Injection in den Top 10 für LLM-Anwendungen und empfiehlt als Gegenmaßnahmen unter anderem, Eingaben und externe Inhalte gemeinsam zu prüfen, Anweisungen und Daten strukturiert zu trennen, Ausgaben zu überwachen und zu validieren sowie Werkzeuge mit least privilege auszustatten.3
Zwei Regeln daraus sind für den Betrieb entscheidend. Erstens: Die Rechte eines Modells werden so vergeben wie die Rechte eines Menschen im Team – ein Agent, der alles darf, ist ein Risiko, sobald er manipuliert wird. Zweitens: Das Modell ist keine Quelle, sondern ein Verarbeiter. Alles, was es zurückgibt, wird behandelt wie eine Eingabe von außen: geprüft, validiert, escaped.
Für Anwendungen, die ein Modell mit Werkzeugen verbinden, ist eine eigene Prüfung sinnvoll. Mein Sicherheitsaudit für KI-Anwendungen geht den Datenweg Ihrer Anwendung durch und prüft Prompt Injection, Datenabflüsse und Werkzeugrechte, bevor Nutzer oder Angreifer sie auslösen.
Rechtsrahmen: was Sie wissen müssen, bevor Sie bauen
Die EU-AI-Verordnung (Verordnung (EU) 2024/1689) gilt seit dem 2. August 2026 vollständig, mit Ausnahmen für bestimmte Hochrisiko-Systeme, die erst später greifen.1 Für die Integration in Bestandssoftware sind drei Punkte praktisch relevant:
- Risikoklasse. Nicht jede KI-Funktion fällt unter dieselbe Risikoklasse. Die Einstufung richtet sich danach, wofür das System verwendet wird – nicht danach, wie es technisch gebaut ist.
- Transparenzpflichten. Nutzer, die mit einem KI-System interagieren, müssen darüber informiert werden, wenn das System eine natürliche Person simuliert.
- KI-Kompetenz. Die Verordnung verlangt seit dem 2. Februar 2025, dass Anbieter und Betreiber über angemessene KI-Kompetenz verfügen.
Die Einordnung eines konkreten Systems ist eine Rechtsfrage und keine Technikfrage. Die Übersicht der Fristen und Pflichten finden Sie auf der Seite EU AI Act: Fristen und Pflichten; für die verbindliche Einstufung Ihrer Anwendung ist eine rechtliche Prüfung der richtige Weg.
Für die organisatorische Seite empfiehlt sich ein dokumentiertes Vorgehen statt einer Sammlung Einzelentscheidungen. Das BSI hat zu KI in der IT-Sicherheit einen Kriterienkatalog für KI-Cloud-Dienste (AIC4) und Maßnahmen für den sicheren, robusten und nachvollziehbaren Einsatz von KI veröffentlicht.4 Wer die KI-Funktionen im Betrieb nachweislich führen will, hat mit der ISO/IEC 42001 einen etablierten Rahmen für ein Managementsystem für KI, mit Risikobewertung, Rollen und laufender Verbesserung.5
Häufige Fragen zur KI-Integration in bestehende Software
Wie lange dauert eine KI-Integration in eine bestehende Anwendung?
Das hängt davon ab, ob Sie eine vorhandene Schnittstelle anbinden oder eine neue aufbauen. Bei vorhandenen Datenquellen ist der aufwendigste Teil selten der Modellaufruf, sondern die Durchsicht von Bestandslogik, Berechtigungen und Fehlerwegen. Belastbare Zeiträume nenne ich Ihnen nach einem Blick in den Code und in die Datenstrukturen – eine Schätzung ohne diesen Blick ist keine.
Wir haben bereits eine KI-Funktion. Lohnt sich eine Überarbeitung?
Prüfen Sie drei Dinge: Gibt es einen Testsatz aus echten Fällen, an dem sich Qualität messen lässt? Gibt es einen regelbasierten Rückfall, wenn der Anbieter ausfällt? Und wissen Sie, was ein Aufruf kostet und wie lange er dauert? Wenn eine dieser drei Fragen kein klares "ja" bekommt, ist die Überarbeitung in der Regel der kleinere Schritt – die fachliche Funktion bleibt, der Betrieb wird belastbar. Die Kosten für eine solche Überarbeitung hängen vom Umfang ab; Angebote bekommen Sie über die Leistungsseite.
Lohnt sich KI-Integration überhaupt, oder reicht eine Regel?
Beginnen Sie mit der Frage, ob der Anwendungsfall überhaupt Textverarbeitung braucht. Ein Sortiervorgang, eine Berechnung, eine Plausibilitätsprüfung – das sind Fälle für deterministische Logik. KI lohnt sich dort, wo unstrukturierte Eingaben verstanden werden müssen: E-Mails, Anfragen, Verträge, Support-Tickets, Dokumente. Die Entscheidungstabelle oben hilft bei dieser Sortierung; und wenn Sie unsicher sind, ist ein Architektur-Audit der ehrliche Einstieg: Sie bekommen eine Entscheidungsgrundlage statt einer Schätzung.
Ihr nächster Schritt: der Anwendungsfall, nicht das Modell
Der übliche Fehler ist, mit dem Modell zu beginnen. Der richtige beginnt mit dem Prozess, der besser laufen soll. Drei Angaben genügen für eine erste Einschätzung:
- Welcher Vorgang in Ihrer Anwendung soll KI übernehmen – und welcher darf es auf keinen Fall?
- Welche Daten sind beteiligt, und verlassen sie dabei Ihr System?
- Wie viele Nutzeraktionen betrifft das, und wie teuer darf ein Aufruf maximal sein?
Mit diesen drei Werten lässt sich sagen, ob KI hier das richtige Werkzeug ist, wo die Schnittstelle liegt und welcher Aufwand entsteht. Sie finden das passende Angebot unter KI-Integration in bestehende Software; die laufenden Kosten im TCO-Rechner, das Vorgehen bei mehreren Anwendungsfällen in der KI-Automatisierung.
Bestandssoftware, die KI vertragen soll?
Schildern Sie mir den Vorgang und die beteiligten Daten. Ich prüfe, ob KI hier das richtige Werkzeug ist, wo die Schnittstelle liegt und wie der Betrieb abgesichert wird – bei Bedarf als fester Festpreis, sonst als klare Einschätzung.
Quellen
- Europäisches Parlament und Rat, „Verordnung (EU) 2024/1689 (Artificial Intelligence Act)" – Rechtsakt und Zeitplan der Anwendung, abgerufen am 13.11.2026. https://eur-lex.europa.eu/eli/reg/2024/1689/oj
- Europäisches Parlament und Rat, „Verordnung (EU) 2016/679 (Datenschutz-Grundverordnung)" – Art. 5 (Datenminimierung) und Art. 6 (Rechtsgrundlagen), abgerufen am 13.11.2026. https://eur-lex.europa.eu/eli/reg/2016/679/oj
- OWASP GenAI Security Project, „OWASP Top 10 for LLM Applications 2025" (u. a. LLM01 Prompt Injection, LLM06 Excessive Agency) sowie „LLM Prompt Injection Prevention Cheat Sheet", abgerufen am 13.11.2026. https://genai.owasp.org/llm-top-10/ und https://cheatsheetseries.owasp.org/cheatsheets/LLM_Prompt_Injection_Prevention_Cheat_Sheet.html
- Bundesamt für Sicherheit in der Informationstechnik (BSI), „Künstliche Intelligenz" – Kriterienkatalog für KI-Cloud-Dienste (AIC4) sowie die Übersichtsdarstellung „Sicherer, robuster und nachvollziehbarer Einsatz von KI", abgerufen am 13.11.2026. https://www.bsi.bund.de/DE/Themen/Unternehmen-und-Organisationen/Informationen-und-Empfehlungen/Kuenstliche-Intelligenz/kuenstliche-intelligenz_node.html
- ISO/IEC, „ISO/IEC 42001:2023 Information technology — Artificial intelligence — Management system" – Anforderungen an ein Managementsystem für KI, Edition 1 (2023-12), abgerufen am 13.11.2026. https://www.iso.org/standard/81230.html
Stand: 13.11.2026. Fristen und Pflichten des EU AI Act sowie Veröffentlichungen der genannten Organisationen können sich mit neuen Rechtsakten, Leitlinien und Releases ändern. Die Einstufung des eigenen Anwendungsfalls und die datenschutzrechtliche Bewertung sind Rechtsfragen und gehören vor dem Produktivbetrieb geprüft. Konkrete Termine und Aufwände für Ihr Projekt bitte mit mir abstimmen.